
Найди гидрант! Почему «капча» постепенно вымирает?
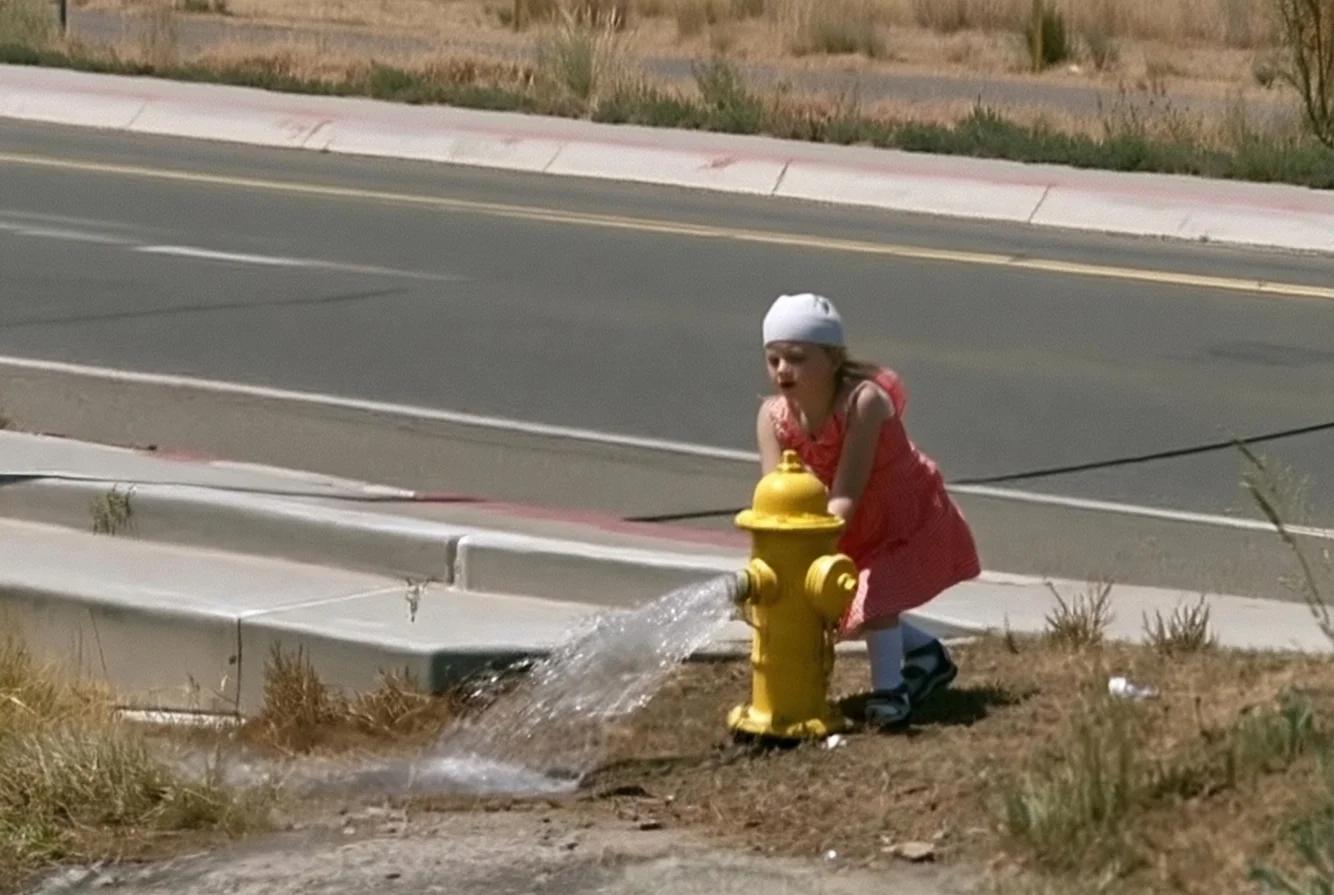
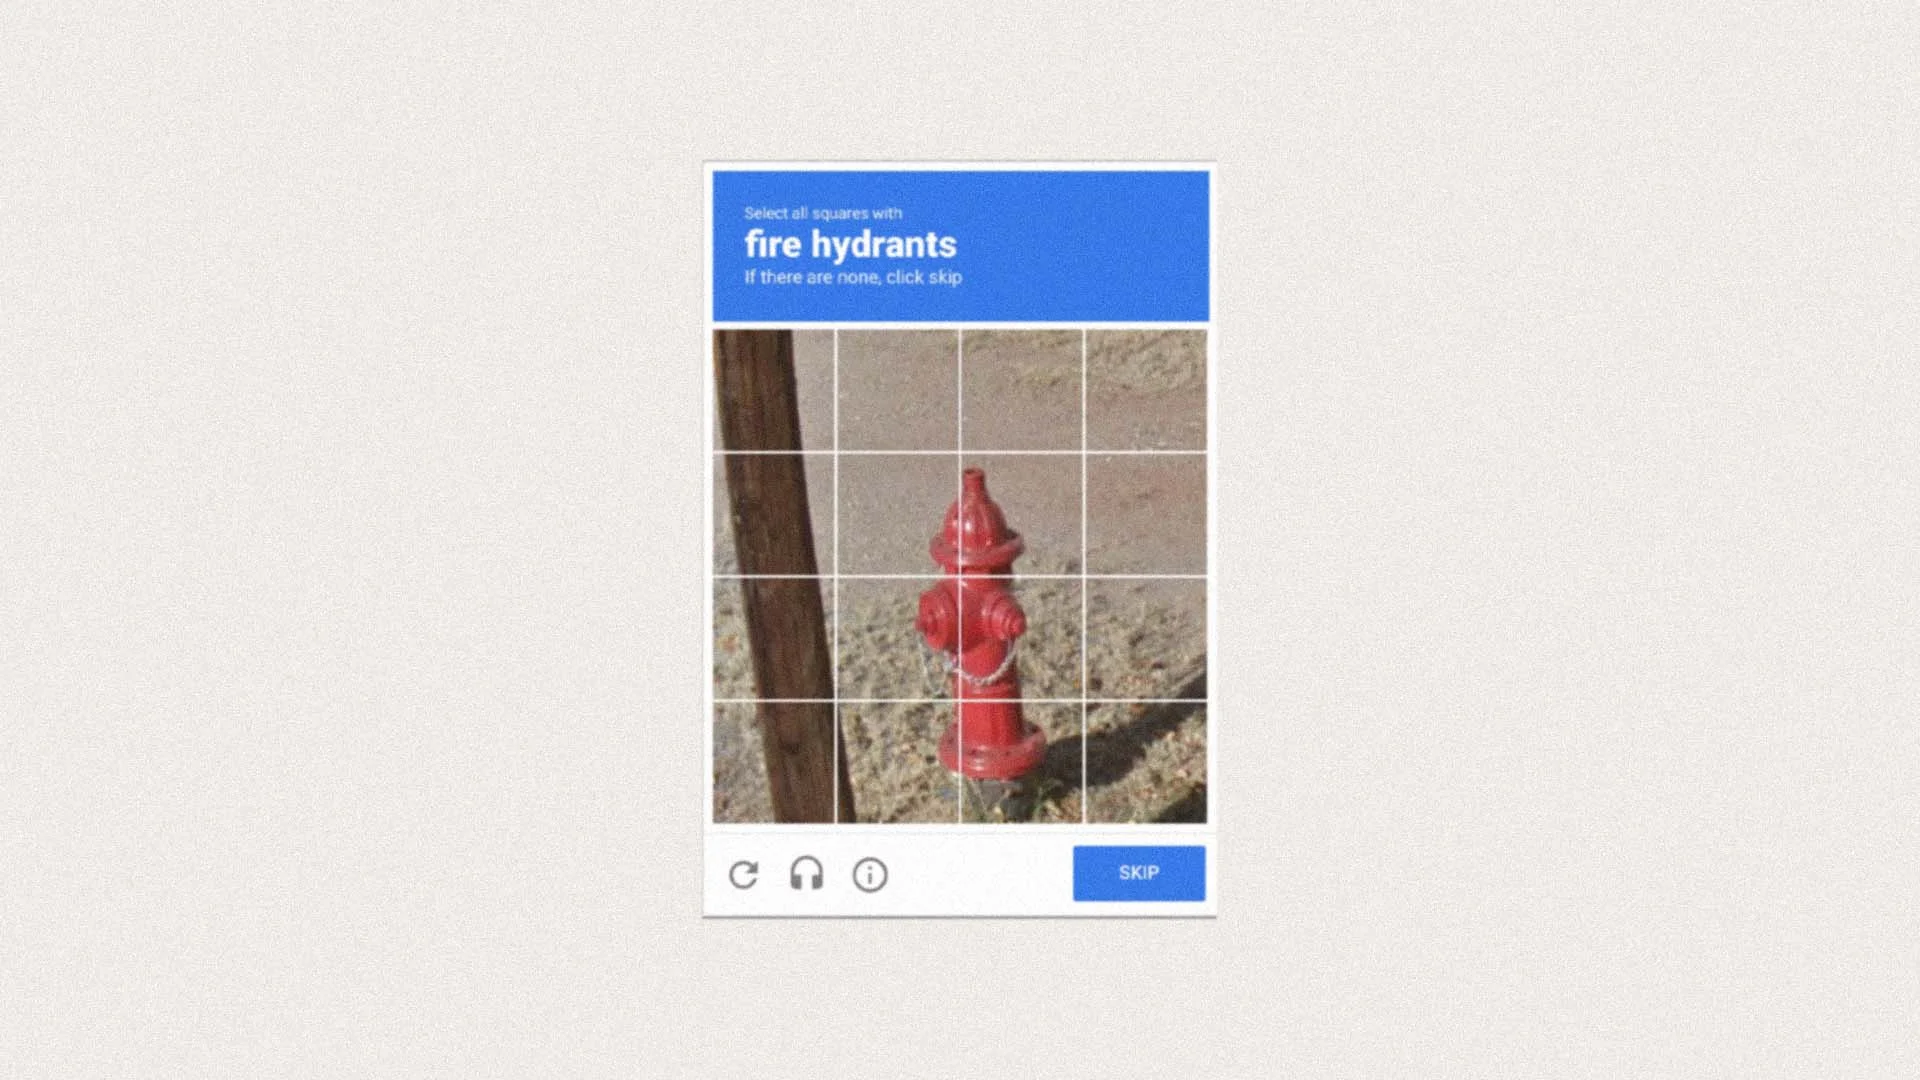
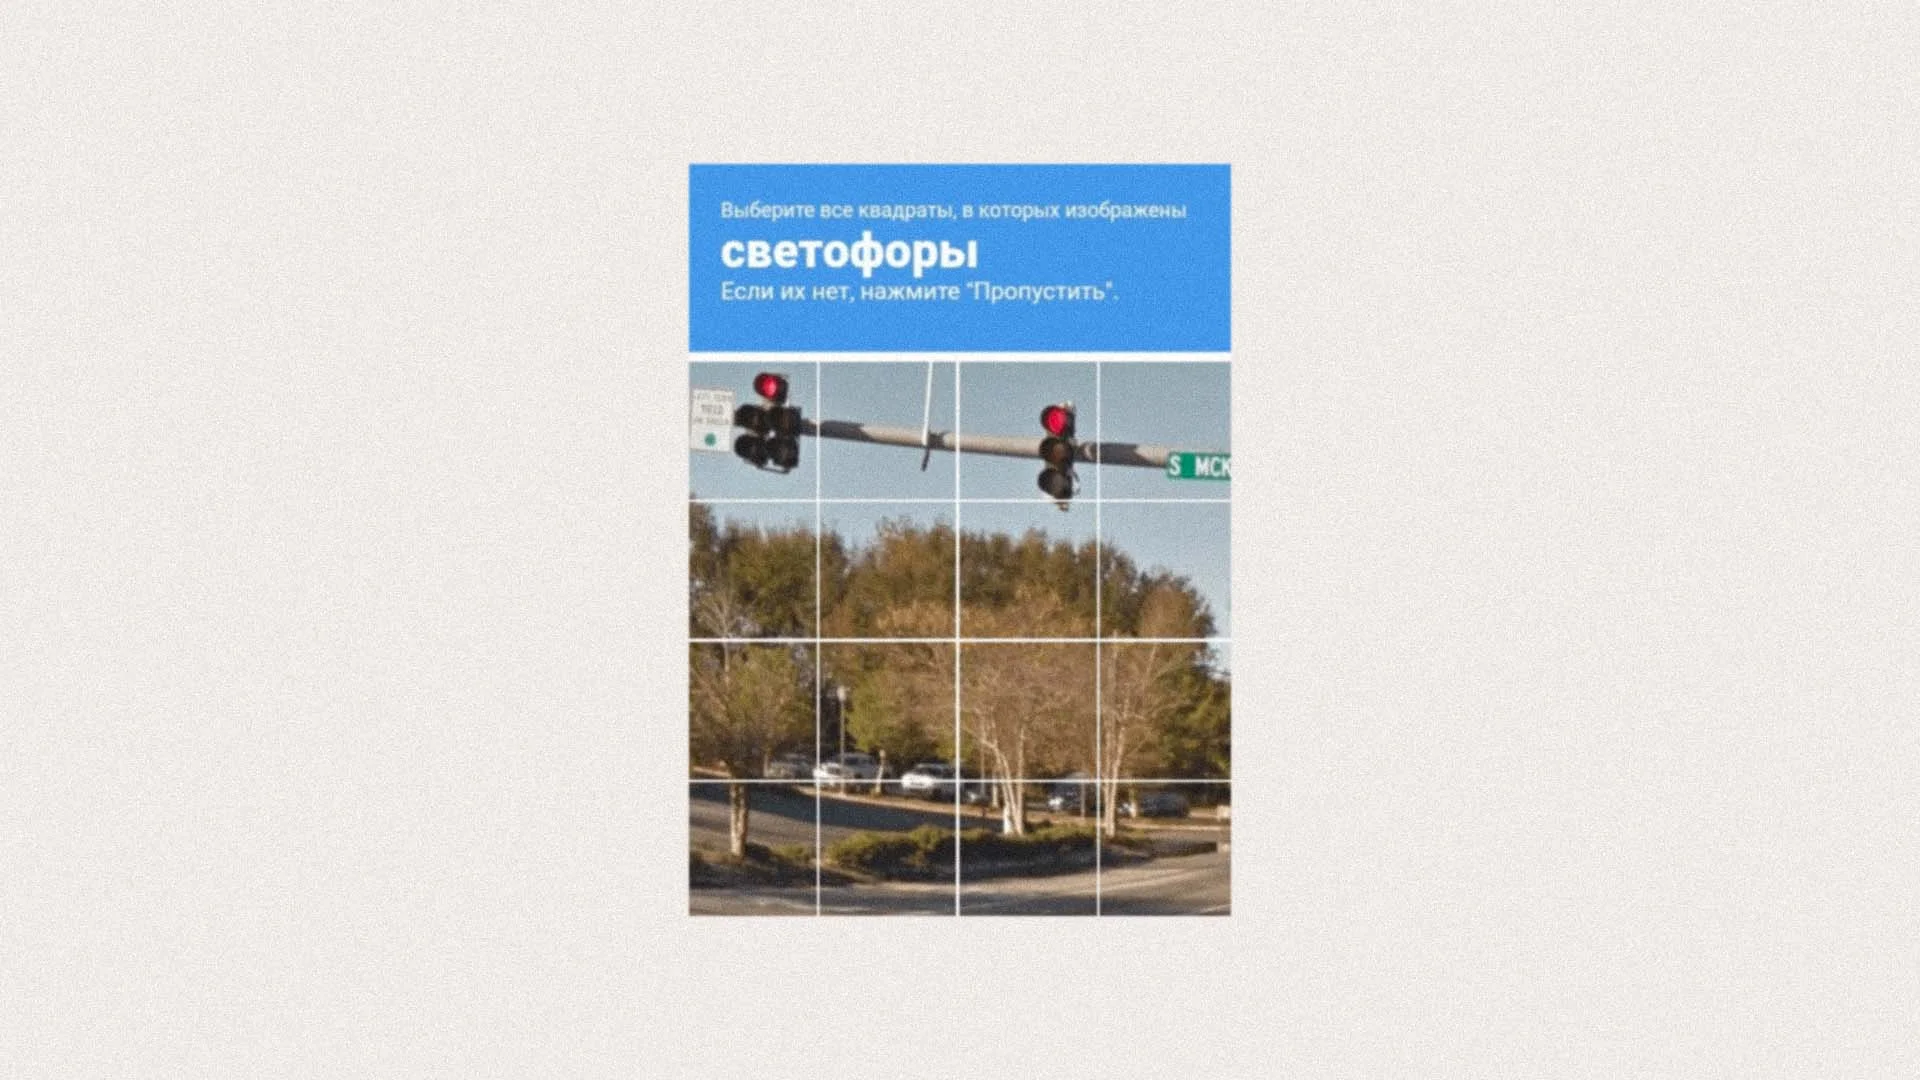
Когда сайт просит нас отметить на картинке все велосипеды, пожарные гидранты или светофоры, он запускает проверку: человек перед ним или компьютерный алгоритм. Такие тесты — частный случай CAPTCHA, главная задача которых — быть простыми для людей и практически невыполнимыми для роботов. Именно поэтому в заданиях используют знакомые повседневные сюжеты, которые каждый из нас распознает за секунду.
Благодаря своей наглядности графические тесты стали самой узнаваемой формой CAPTCHA — именно их мы представляем, когда слышим это слово. Однако технологии не стоят на месте. Сегодняшние системы безопасности все чаще оценивают не только правильность ответа, но и контекст: то, как ведет себя пользователь на странице, и особенности работы его браузера.
Кто и зачем придумал CAPTCHA
Аббревиатура CAPTCHA расшифровывается как Completely Automated Public Turing test to tell Computers and Humans Apart — «полностью автоматический публичный тест Тьюринга для различения компьютеров и людей». По сути, это «тест Тьюринга наоборот». В классическом варианте, описанном математиком Аланом Тьюрингом в 1950 году в статье «Вычислительные машины и разум», человек пытается понять, кто с ним переписывается — другой человек или компьютер. Задаваясь вопросом «Могут ли машины мыслить?», Тьюринг предложил оценивать не абстрактный разум, а практические навыки в «игре в имитацию». В случае же с капчей роли меняются: теперь компьютерная программа проверяет, сидит ли по ту сторону экрана живой человек.
Первые подобные тесты появились на рубеже 1990-х и 2000-х годов, когда интернет-ресурсы захлестнула волна спама, автоматических регистраций и хакерских атак. Одним из пионеров в этой области стал поисковик AltaVista в 1997 году. Чтобы роботы не могли бесконтрольно добавлять ссылки в поисковый индекс, разработчики начали использовать картинки с искаженным текстом. Компьютерное зрение тех лет не могло распознать деформированные буквы, а человек справлялся с этим без труда.
Сам же термин CAPTCHA в 2000 году ввели исследователи из Университета Карнеги — Меллона: Луис фон Ан, Мануэль Блюм, Николас Хоппер и Джон Лэнгфорд. Они научно формализовали эту идею и превратили ее в общедоступный стандарт безопасности, сознательно отказавшись от оформления коммерческих патентов. Фактически команда адаптировала классический тест Тьюринга для веб-среды, создав инструмент персонального контроля — «проверку на человечность».
Почему картинки стали символом CAPTCHA
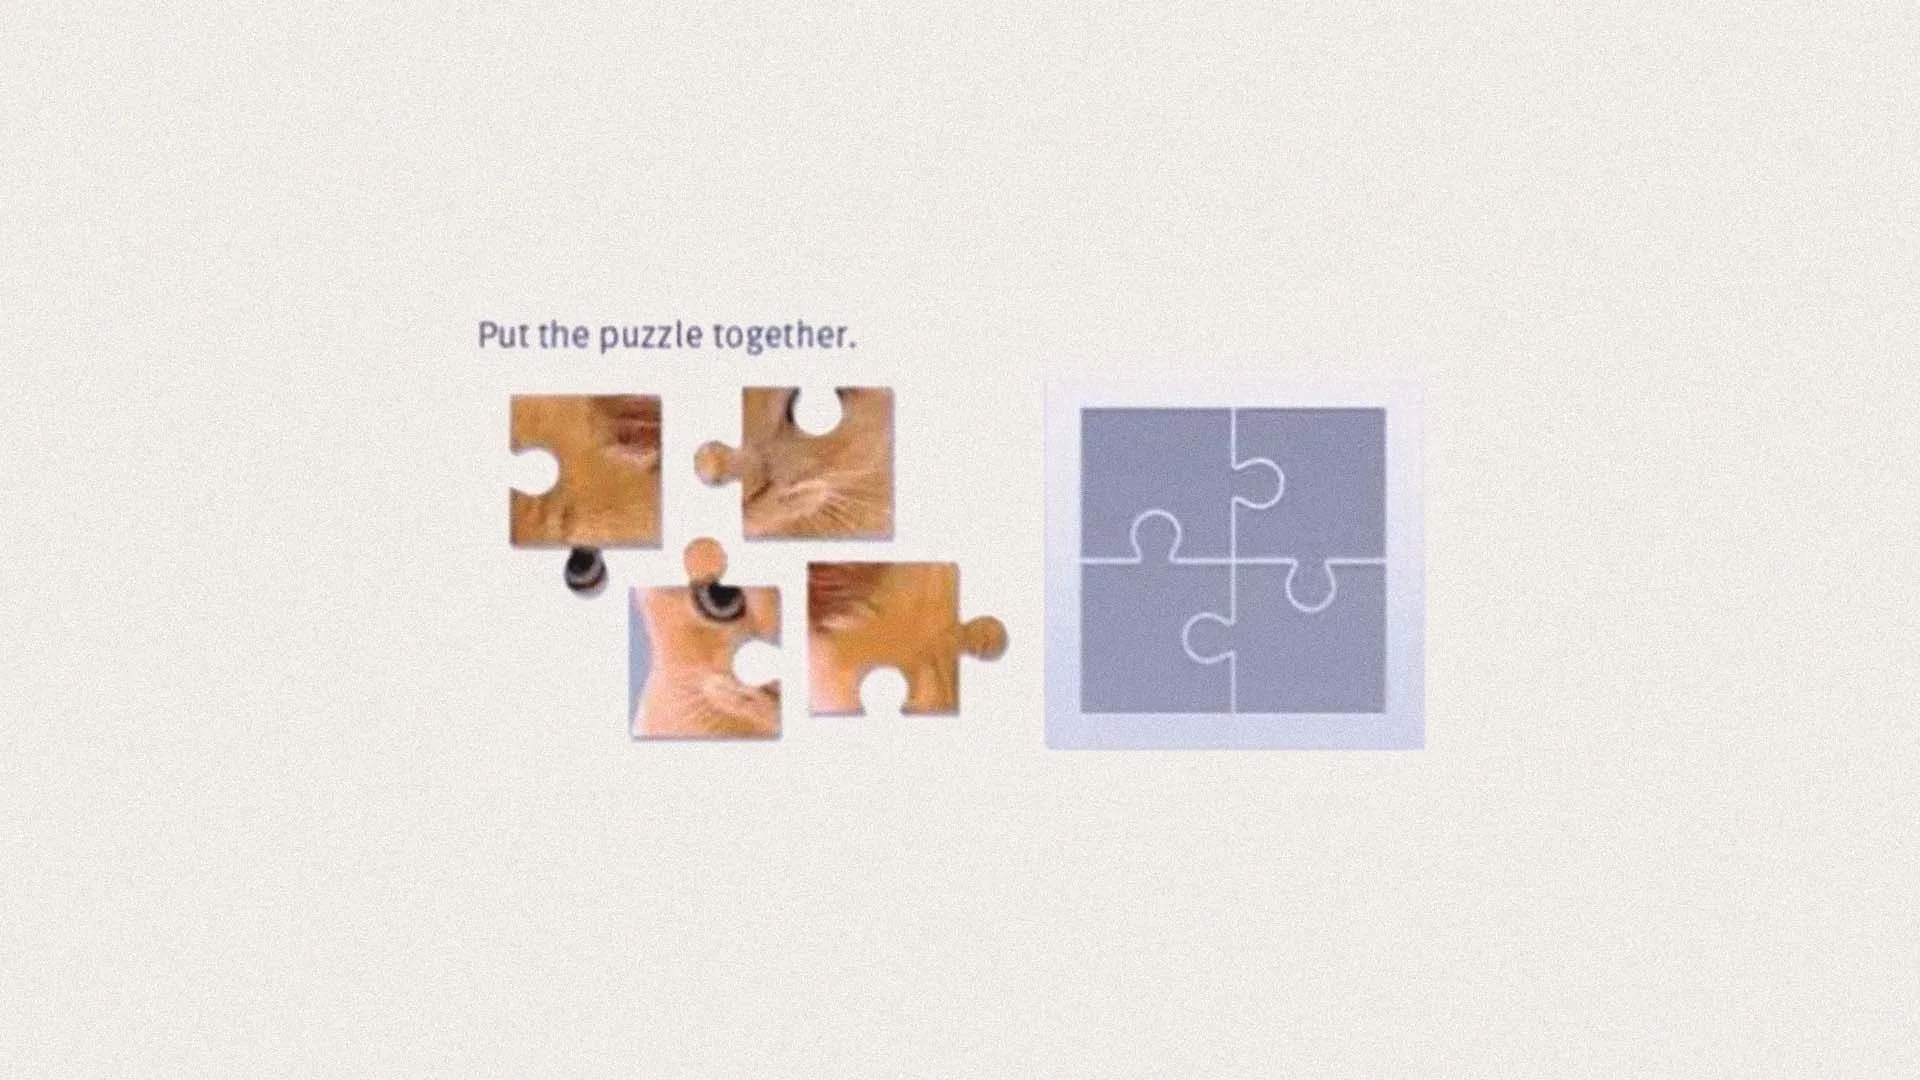
Первые массовые тесты были в основном текстовыми: человеку показывали искаженную, наклоненную или подчеркнутую линию из символов и просили ее перепечатать. Позже появились альтернативные варианты — от простых математических задач и аудиокапч до мини-игр. Разработчики искали то, что человек делает интуитивно, а автоматический скрипт — с трудом. Однако ни один метод не оставался надежным навсегда: как только проверка становилась массовой, ее данные использовали для обучения новых, более продвинутых ботов.
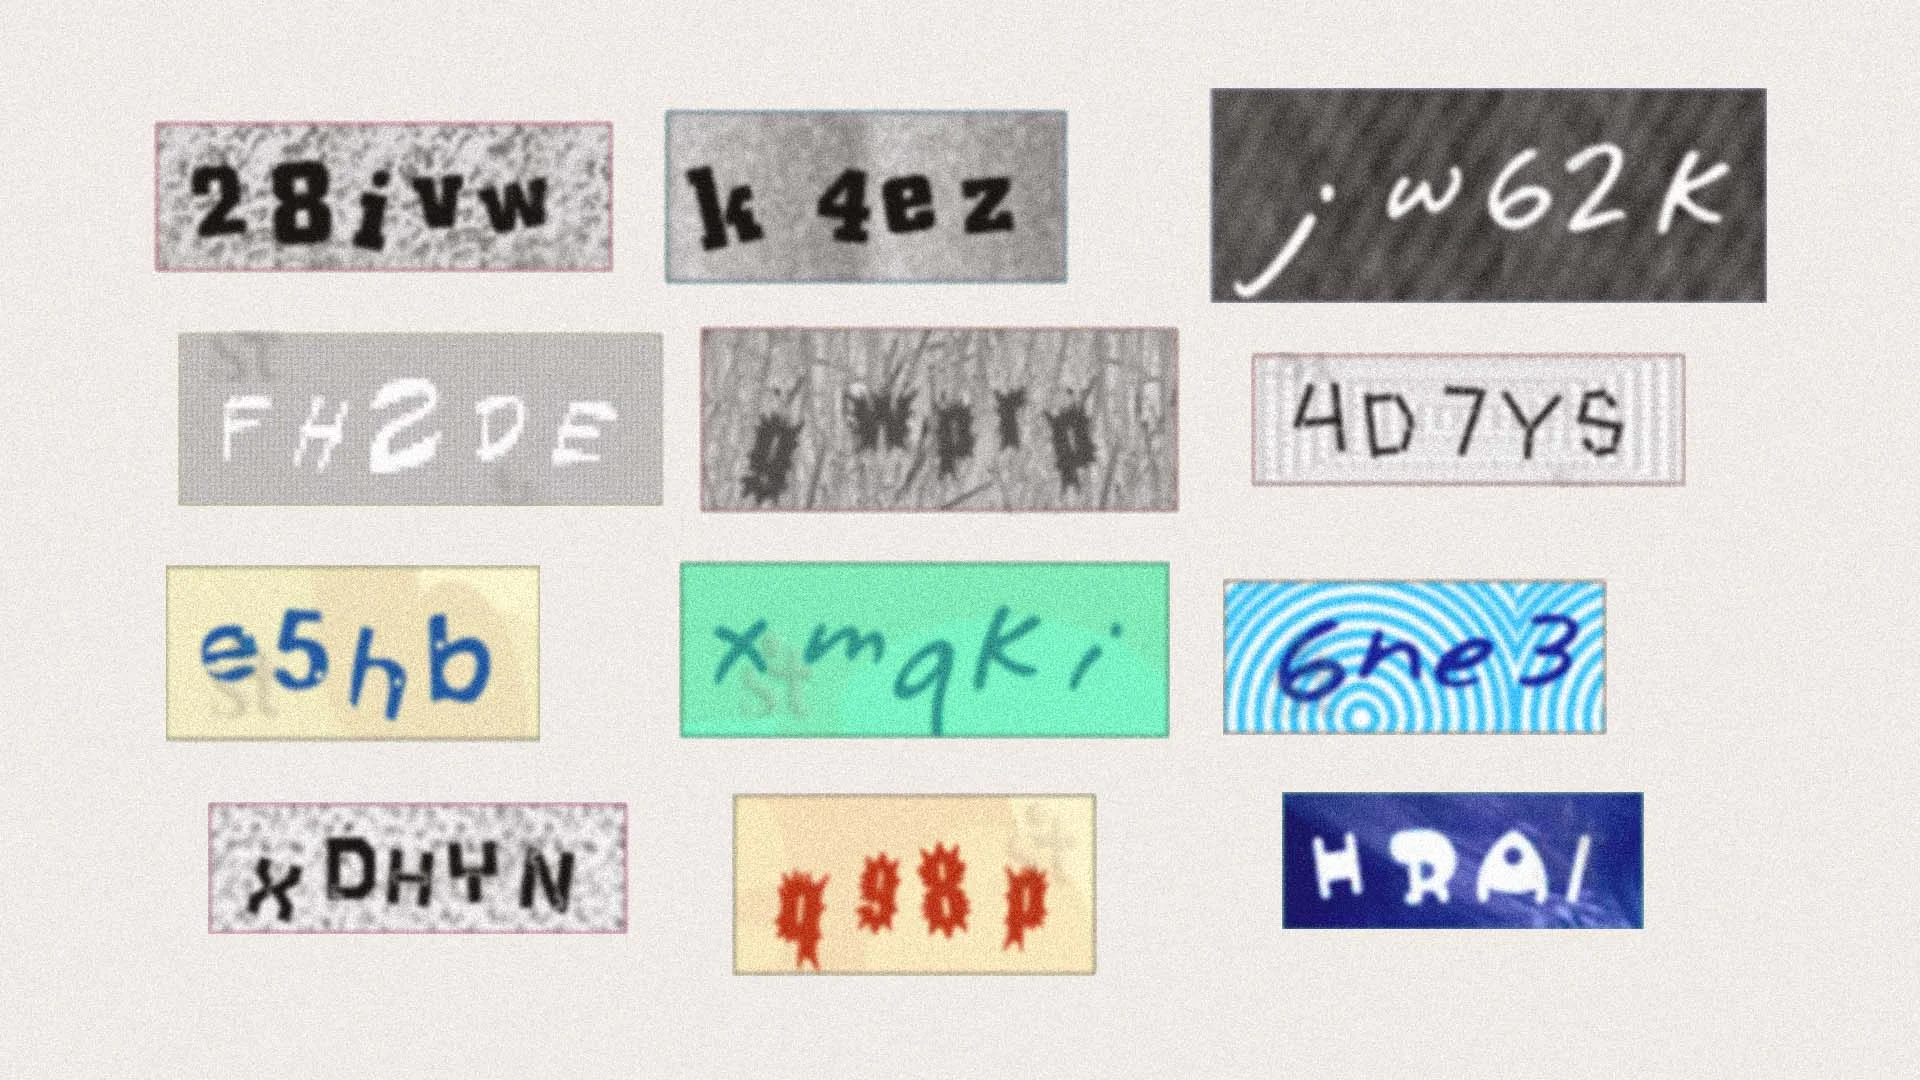
В 2007 году Луис фон Ан и его коллеги запустили reCAPTCHA — систему, которая совместила безопасность с общественной пользой. Пользователю показывали два слова: контрольное (с известным системе ответом) и «слепое» — из отсканированной книги или газеты, которую не мог распознать компьютер. Если пользователь правильно вводил первое слово, система засчитывала и второе. Таким образом миллионы людей ежедневно помогали оцифровывать мировую литературу. В сентябре 2009 года эту технологию выкупила компания Google и стала использовать ее, в частности, для проекта Google Books.
Со временем нейросети научились читать деформированный текст лучше людей, и буквы перестали быть барьером. Тогда Google перевела reCAPTCHA на визуальные образы — фотографии улиц, автомобили, дорожные знаки и светофоры. Так появились знаменитые сетки из картинок с просьбой отметить «все автобусы» или «все пожарные гидранты». Разгадывая их, пользователи интернета сами того не замечая стали учителями для ИИ: их ответы использовались для обучения алгоритмов беспилотных автомобилей Google.
Откуда берутся картинки: датасеты и микрозадачи
Картинки для CAPTCHA — это не случайные кадры из интернета, а фрагменты огромных баз данных (датасетов). Чаще всего используются снимки городских улиц, на которых компьютеру нужно помочь распознать дорожные объекты.
Именно доступ к большим массивам данных создает преимущество крупных технологических компаний. Google, Meta, Amazon и Apple располагают огромным количеством изображений и пользовательских данных, которые применяются для разработки и проверки моделей машинного обучения.
В качестве одного из самых наглядных примеров такого подхода можно привести reCAPTCHA от Google: ответы на ее вопросы стали касаться объектов городской среды — велосипедов, машин, светофоров и дорожных знаков. Такие метки стали основой для развития компьютерного зрения, в том числе для систем, которым необходимо распознавать объекты на дороге.
Таким образом, CAPTCHA превратилась не только в фильтр от спама, но и в крупнейший в истории механизм массовой разметки визуальных данных. Миллионы пользователей годами выполняли работу бесплатных разметчиков, даже не подозревая, что их ответы могут иметь огромную научную и коммерческую ценность за пределами непосредственной проверки доступа.
Как ИИ научился проходить визуальные капчи
В сентябре 2024 года группа ученых из Швейцарской высшей технической школы Цюриха (ETH Zurich) опубликовала работу, в которой попыталась «взломать» систему Google reCAPTCHA v2 и решить ее визуальные задания автоматическим путем.
Для этого они модифицировали популярную нейросеть YOLO, обучив ее распознавать те самые типичные объекты: автомобили, мосты, светофоры и пожарные гидранты. Результат оказался сенсационным — ИИ достиг 100-процентного успеха в прохождении тестов, тогда как все предыдущие алгоритмы выдавали максимум 68–71%. Более того, количество попыток, которое требовалось боту для разгадки reCAPTCHA v2, совпало с показателями обычного человека. Это окончательно поставило под сомнение саму эффективность картинок как «доказательства человечности».
Почему картинки уходят в прошлое
Авторы исследования и независимые аналитики приходят к общему выводу: классические графические тесты больше не могут надежно отличить человека от нейросети. Проблема не только в том, что искусственный интеллект научился идеально распознавать велосипеды и гидранты. Современные боты успешно совмещают компьютерное зрение с автоматизацией браузера, реалистично имитируют движения мыши и умеют подключать сервисы ручного решения CAPTCHA.
Именно поэтому современные версии reCAPTCHA все чаще анализируют не только сам ответ, но и контекст взаимодействия с сайтом: файлы cookies, историю браузера, IP-адрес, технические характеристики устройства, микроклики курсора и другие сигналы. В reCAPTCHA v3 привычных картинок вообще может не быть: алгоритм в фоновом режиме рассчитывает «индекс подозрительности» профиля. На основе этой оценки сайт сам решает: пропустить пользователя, заблокировать его или отправить на дополнительную проверку.
Это меняет саму идею CAPTCHA. Человек думает, что он просто зашел на страницу, но система непрерывно изучает его поведение до, во время и после совершения целевого действия. Такая модель гораздо эффективнее защищает от спама, но вызывает серьезные вопросы к цифровой приватности, ведь для анализа требуется собирать огромные массивы личных данных пользователей.
В июне 2026 года Google начала ограниченное тестирование еще одной технологии — Hand Gesture Verification («верификация жестов рук»). Вместо поиска светофоров пользователю предлагают дать сайту доступ к веб-камере и выполнить простое движение — например, помахать рукой. Нейросеть считывает 21 координатную точку на кисти, проверяя биомеханику человека в реальном времени. Этот подход уже вызвал шквал критики. Он требует наличия камеры, отсекает пользователей с ограниченными возможностями здоровья и переносит спор о «доказательстве человечности» из области разгадывания загадок в плоскость тотального контроля за телом и поведением.
Противники CAPTCHA
Капчи давно критикуют специалисты по безопасности, UX-дизайнеры, активисты и рядовые пользователи.
Во-первых, они создают препятствия для людей. Ошибки при выборе картинок, нечитаемые символы, плохо работающие аудиозадания и необходимость несколько раз подтверждать свою «человечность» ради простого действия делают интерфейс раздражающим. Для людей с нарушениями зрения, слуха или моторики CAPTCHA может оказаться не просто неудобной, а фактически непроходимой.
Во-вторых, CAPTCHA не гарантирует защиту. Простые задания обходятся распознаванием текста и изображений, сложные — специализированными моделями, автоматизацией браузера или сервисами «ферм разгадывания», где за небольшую плату задачи решают реальные люди.
Наконец, сама проверка имеет огромную социальную цену. Инженер-исследователь компании Cloudflare Тибо Менье подсчитал, что совокупное время, которое пользователи интернета тратят на решение CAPTCHA, составляет примерно 500 человеко-лет в день.
Отсюда возникает резонный вопрос: работают ли машины на людей или люди все чаще решают задачи для машин? В случае CAPTCHA ответ неоднозначен. Пользователь получает доступ к сайту и защиту от части автоматических атак, а оператор платформы бесплатно забирает размеченные данные и сигналы поведения.
Визуальная культура против бинарного вопроса
Итальянский исследователь Симоне Натале обращает внимание на культурный эффект CAPTCHA: богатое и многогранное изображение редуцируется до бинарного вопроса «есть велосипед или нет».
В таком формате нет места уточняющим вопросам. Считать ли моноцикл велосипедом? Должен ли под мостом находиться водный поток, чтобы объект соответствовал категории «мост»? Интерфейс требует только ответа «да» или «нет», то есть превращает визуальный опыт в дискретную метку 0/1.
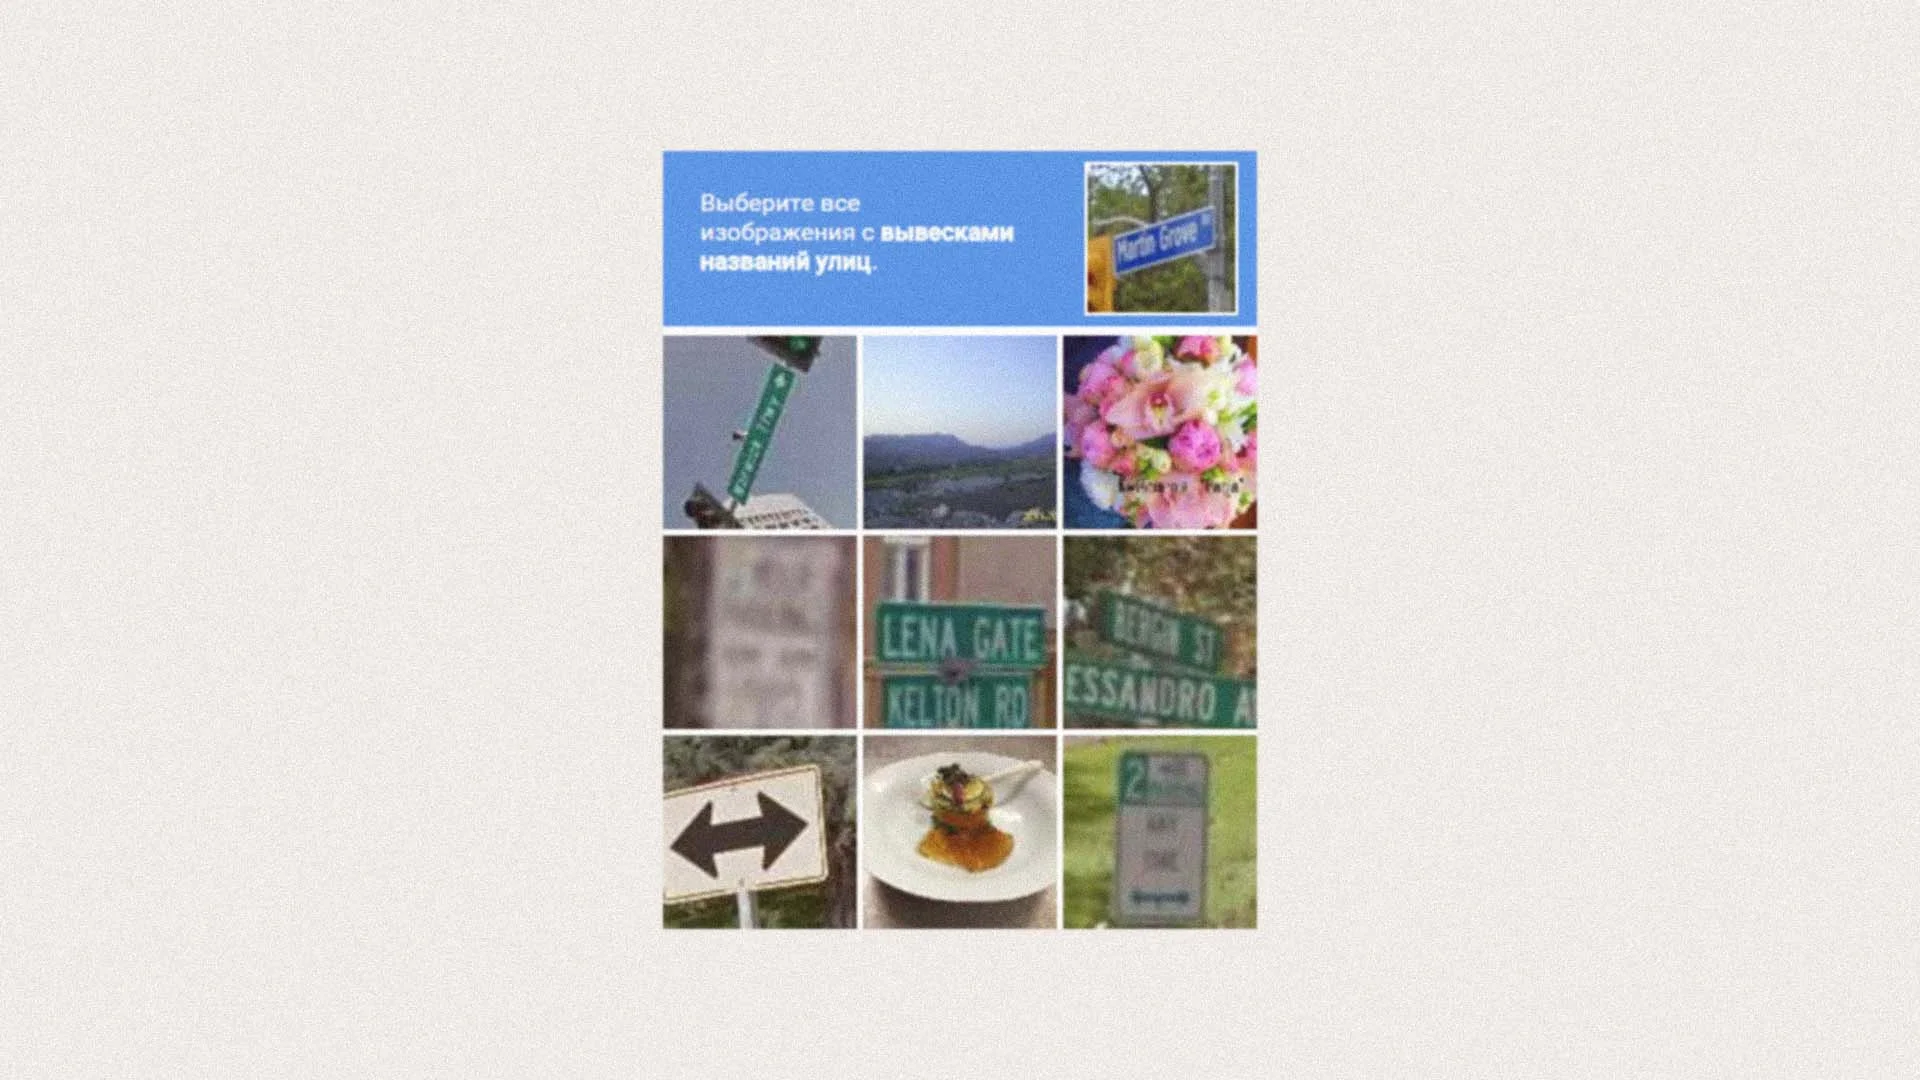
Получается, что не машина воспроизводит всю сложность человеческого видения, а человек подстраивает свое восприятие под ограничения интерфейса. Мы не описываем изображение, не объясняем, что именно увидели и почему сомневаемся. Мы лишь подгоняем сложную сцену под корректный для программы ответ: объект присутствует или отсутствует.
В этом смысле выражение «компьютерное зрение» может вводить в заблуждение. Нейросеть не видит изображение так, как видит его человек: она обрабатывает матрицу чисел и вычисляет статистические закономерности, связанные с нужной категорией. Она может уверенно распознать объект, не обладая человеческим зрительным опытом и не понимая изображения в культурном или жизненном смысле.
Что будет с CAPTCHA, когда человек и машина перестанут различаться
По мере того как алгоритмы глубокого обучения улучшают распознавание изображений, классическая CAPTCHA теряет смысл: тест уже не способен надежно отделить человека от машины по возможности «увидеть велосипед на картинке». Это создает парадоксальный замкнутый круг: пользователи решают задания, чтобы доказать, что они не машины; их ответы помогают совершенствовать системы распознавания; улучшившиеся системы делают старые CAPTCHA бесполезными.
Это не означает, что проверки исчезли или что любой бот уже беспрепятственно проходит любую защиту. Скорее, происходит переход от отдельной головоломки к комплексной оценке риска. Сайт учитывает множество сигналов, а CAPTCHA появляется только тогда, когда запрос кажется подозрительным. При этом сама оценка может быть ошибочной: человек с необычным устройством, VPN, отключенными сценариями или нестандартным поведением иногда выглядит для алгоритма как бот.
Одно из направлений развития — proof of personhood, или «доказательство человечности». Это собирательное название для методов, которые пытаются подтвердить уникальное человеческое присутствие без обязательного решения традиционной картинки. В отличие от проверки личности, такой подход не обязательно должен сообщать имя, адрес или паспортные данные. Его задача — доказать лишь одно: перед сервисом находится живой человек, а не бесконечное множество автоматических аккаунтов.
У каждого подхода есть обратная сторона. Поведенческий анализ может превращаться в скрытое наблюдение, камера и биометрические признаки вызывают вопросы о приватности и доступности, аппаратные ключи стоят денег и доступны не всем, а криптографическое подтверждение устройства не тождественно доказательству уникального человека. Поэтому будущее CAPTCHA — это не просто поиск «еще более трудной картинки», а выбор между безопасностью, удобством, доступностью и правом пользователя оставаться анонимным.
В этом контексте исходный вопрос Тьюринга обретает новый оттенок: речь уже не столько о том, «может ли машина мыслить», сколько о том, готовы ли люди поверить в такую возможность и воспринимать поведение машин как разумное.
Автор: Александр Дюльденко